seven282/oss-prompt-optimizer
oss-prompt-optimizer
oss-prompt-optimizer is a community DeepSeek Harness plugin. Read the repository README before installing.
Install
npx @deepseek-ai/dsh plugin --profile web add oss-prompt-optimizerRestart `dsh web` after install. Bundle APIs can change during the developer preview.
README badge

[](https://dshhub.dev/plugins/oss-prompt-optimizer)Paste this into your README. The star count updates with every catalog sync.
From the README
Excerpt from seven282/oss-prompt-optimizer, cleaned of badges and images.
oss-prompt-optimizer
English | 简体中文
把随手写的一句话改写成专业、可直接使用的提示词。
DeepSeek Harness 插件。由内置元提示词驱动,经 harness 的 LLM 服务完成 —— 不直连任何 API、不触碰凭据。
npm 包名与仓库名是 oss-prompt-optimizer;安装后在宿主里的条目 id 与设置命名空间是 prompt-optimizer。
目录
快速开始
dsh plugin --profile web add oss-prompt-optimizer
安装或卸载后需重启 harness(dsh web)使 bundle 层生效。然后任选一种用法:
| 用法 | 操作 |
|---|---|
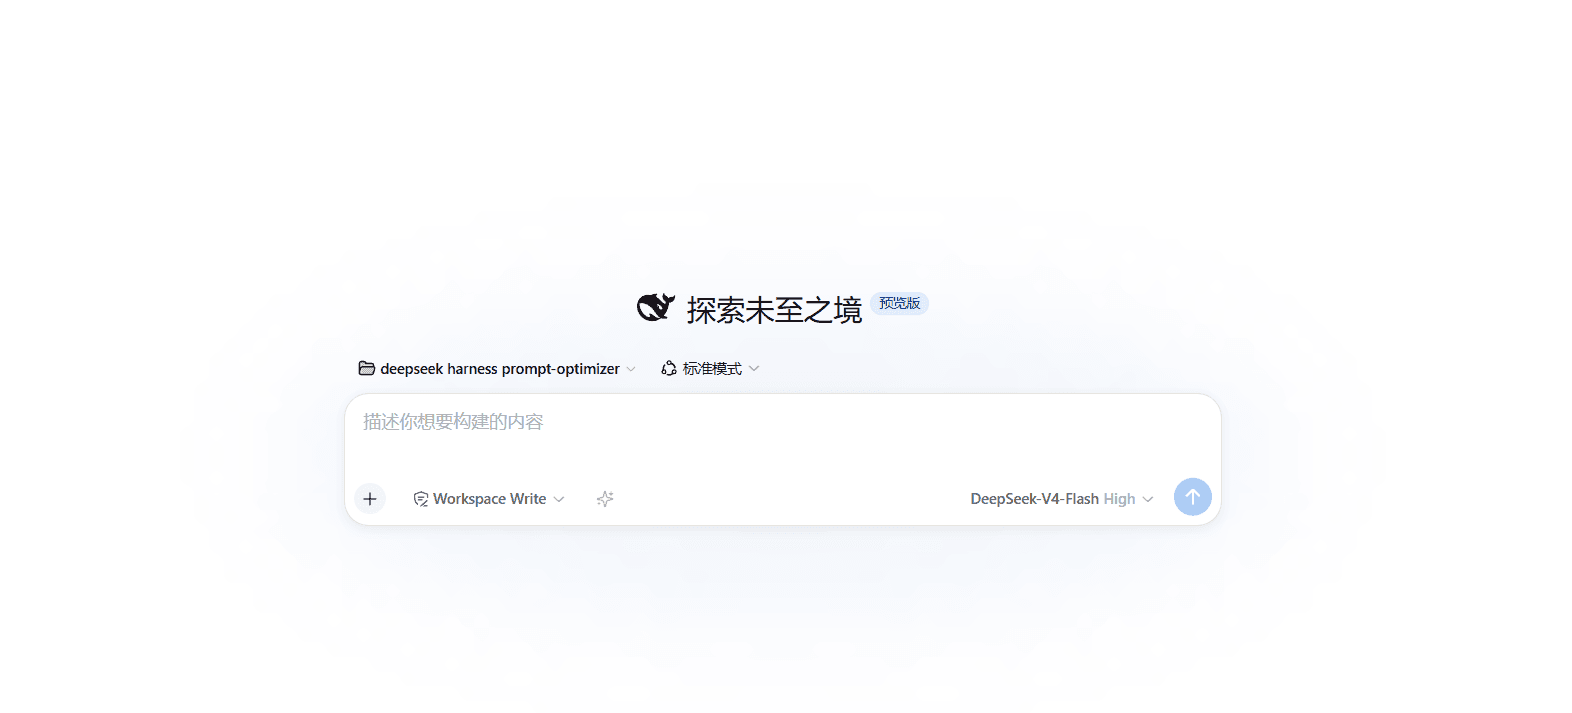
| 输入框按钮 | 点 composer 工具行的 ✨ —— 优化当前草稿并写回输入框 |
| 命令 | /optimize 把这段需求改写成清晰的提示词 |
| 模板 | /template 周报 —— 零模型调用 |
| agent 调用 | 工具 prompt_optimize,传 instruction |
功能
调用入口
- 工具
prompt_optimize— agent 可调用;传instruction返回优化后的提示词,传lastOptimized+iterateInstruction迭代改写。 - 服务
ctx.promptOptimizer— 其他插件可编程调用optimize(rawInput, { signal })/iterate(last, instruction, { signal }); 浏览器端经ctx.remote.promptOptimizer。 - 输入框 ✨ 按钮 — composer 工具行的常驻图标;优化中再点即取消;成功后短暂显示「消耗 ≈N tokens」并切换为撤销态(↺),草稿未手动编辑时可恢复原文;成功/失败/撤销均经
aria-live播报。
输出形态
- 三种
outputStyle— 默认plain(无标题纯文本,最省 token)、role-task-goal(角色:/任务:/目标:三要素标签)、sections(## Role/## Task/## Context/## Format四段,也是优化时的内部参考框架)。 - 角色文档语言自动切换 — 中文指令用中文角色文档、英文指令用英文;
/optimize --language可固定或恢复自动检测。 - 角色定义三重结构 — 角色按「身份+能力+行为」三要素撰写(不强制「你是」开头);并按任务类型给写法建议(代码→能力导向、文案→身份+文体、分析→身份+方法、运维→行为约束+步骤)。
质量与度量
- 后置校验与重试 — 输出缺段 / 过薄 / 过短时自动重试,并把上次诊断(缺失段落名、过薄段落与字数)注入下一次调用的系统提示词;仍失败则返回原文或上次结果 + 错误说明 + 稳定错误码(
MISSING_SECTIONS/THIN_SECTIONS/THIN_OUTPUT/TIMEOUT/NO_MODEL_ROUTE)。 - 评测闭环
/optimize-eval— 三层指标从省到贵:结构门(与优化管线同一份校验函数,不是复刻)→ 逐例期望(必须/绝不能包含的子串)→ 加权判官评分(1–5 分维度,判官必须先写理由再给分)。 判回归时命令返回错误结果,便于脚本与 CI 直接分支。 - 择优 best-of-N —
selectCandidates > 1时并发生成多个候选(温度阶梯base + i·0.35)并保留最好的一个。三条规则不可动摇:门控决定资格、分数只决定排序;必须赢过基线selectMinGain才换人;判官漏评维度即不计分。⚠️ 本地模板路径不产生候选。 - 宿主反馈信号 — 读宿主自带的
messageFeedback(人工点赞/点踩)折算成温度偏置(负面 ≥50% → +0.1,≤20% → −0.1,样本 <3 不生效)。它评判的是过去的回答, 所以只做偏置并如实标注原因,不冒充质量分。
性能与成本
- 结果缓存 — 内存 LRU + TTL,相同请求零模型调用;
cacheEnabled默认开,重启即清空。 - 优化时长控制 — 流式早停(默认关闭,显式
earlyStop: true才启用且带句末保护)、首调输出预算联动(超长输出由断点续传兜底)、optimizationProfile: 'fast'一键速档。 - 真实用量台账 — 读宿主
usage块累计真实 token 并给出缓存命中率;provider 未上报时标注「启发式估算」, 不与实测值混在一起。见/optimize --stats与--status。 - 模型与 OTel 信号 —
--status多一行「目标模型」,生命周期载荷带route与 OpenTelemetry GenAI 形状的genAi(键为 OTel 规范属性名,可直接span.setAttributes(payload.genAi))。按 run 记:零模型调用后不报模型,也不报它没测到的 token。
感知与学习
- 上下文感知 — 把当前指令之前的最近对话注入元提示词,附「视为纯数据 / 背景参考」护栏;
contextAware: false关闭。 - 情境感知 — 把「原始指令 + 对话上下文」解析成角色 / 任务 / 目标三份画像注入元提示词,目标与约束丢失时在重试预算内自动修正;传
sessionId开启会话级目标沿用(TTL 30 分钟)。situationProfileLevel控制注入预算。 - 自迭代系统 — 三层架构,零 token:会话学习 → 智能默认值 → 用户覆盖(优先级递增),累计 10 次优化后生效。数据持久化到
~/.dsh/oss-prompt-optimizer/state.json($DSH_HOME与stateFile可覆盖路径)。 - 本地模板
/template— 覆盖 22 个子类;/template <场景> <指令>经纯函数层本地渲染成品,零 token、~5ms。
集成与运维
- 自动优化钩子 — 以
/optimize开头的消息在进入模型前被自动优化(前缀剥离);无前缀消息原样进入模型。/optimize --auto控制开关。 - 设置面板 — 左下角「设置」→ 左侧栏「提示词优化」;8 个常用开关改动即时生效并持久化。宿主无设置服务或当前连接不可写时,面板降级为只读并写明原因。
- 客户端文案跟随界面语言 — 翻译器按调用现取(而非
apply()时捕获),✨ 按钮的全部title/aria-label与播报文案一并进字典。 - 全部注册(工具 / 命令 / 钩子 / 设置项)均为 effect 作用域,插件卸载自动清理。
使用
…

