PensiveFei/deep-read-summarize
deep-read-summarize
Deep reading & summarization workflow for DSH: books/papers/videos/web → structured Markdown notes. Plugin parsers, MapReduce deep-read, JSON Schema output.
Install
npx @deepseek-ai/dsh plugin --profile web add github:PensiveFei/deep-read-summarizeRestart `dsh web` after install. Bundle APIs can change during the developer preview.
README badge
[](https://dshhub.dev/plugins/deep-read-summarize)Paste this into your README. The star count updates with every catalog sync.
From the README
Excerpt from PensiveFei/deep-read-summarize, cleaned of badges and images.
deep-read-summarize
Disclaimer: This is an unofficial third-party tool. It is not affiliated with, endorsed by, or sponsored by DeepSeek or the DeepSeek Harness project. "DeepSeek" and "DeepSeek Harness" are trademarks of their respective owners. This project only orchestrates the workflow tool available in your DSH environment; it does not redistribute any DeepSeek software.
⚠️ 最重要:本工具是「辅助精读」工具,不能代替自主学习。 它帮你快速提取、归纳、结构化阅读内容,但真正的理解、思考与批判仍需你自己完成;请始终以原文为准,不要把它当作学习成果本身。
给 DSH(DeepSeek Harness)写的一个精读工作流:输入一本书、一篇论文、一个视频链接或网页,输出一份结构化的标准 Markdown 笔记(YAML frontmatter,可直接放进 Obsidian / Logseq / 静态站点内容目录 / 任意 Markdown 编辑器)。
内容会被拆成若干块,由多个子代理并行精读,再合并成一篇带 YAML frontmatter 的 Markdown。关键结论附原文出处,成稿前有一道质量校验。
使用中遇到问题、或觉得哪里能更好,欢迎随时在 GitHub issue 反馈。
注意:DSH 目前是 developer preview,接口可能变化。本仓库针对特定版本的 workflow 工具语义编写,见下文兼容性。
平台:Windows / macOS / Linux 同等支持(0.3.9 起),详见下文支持平台。
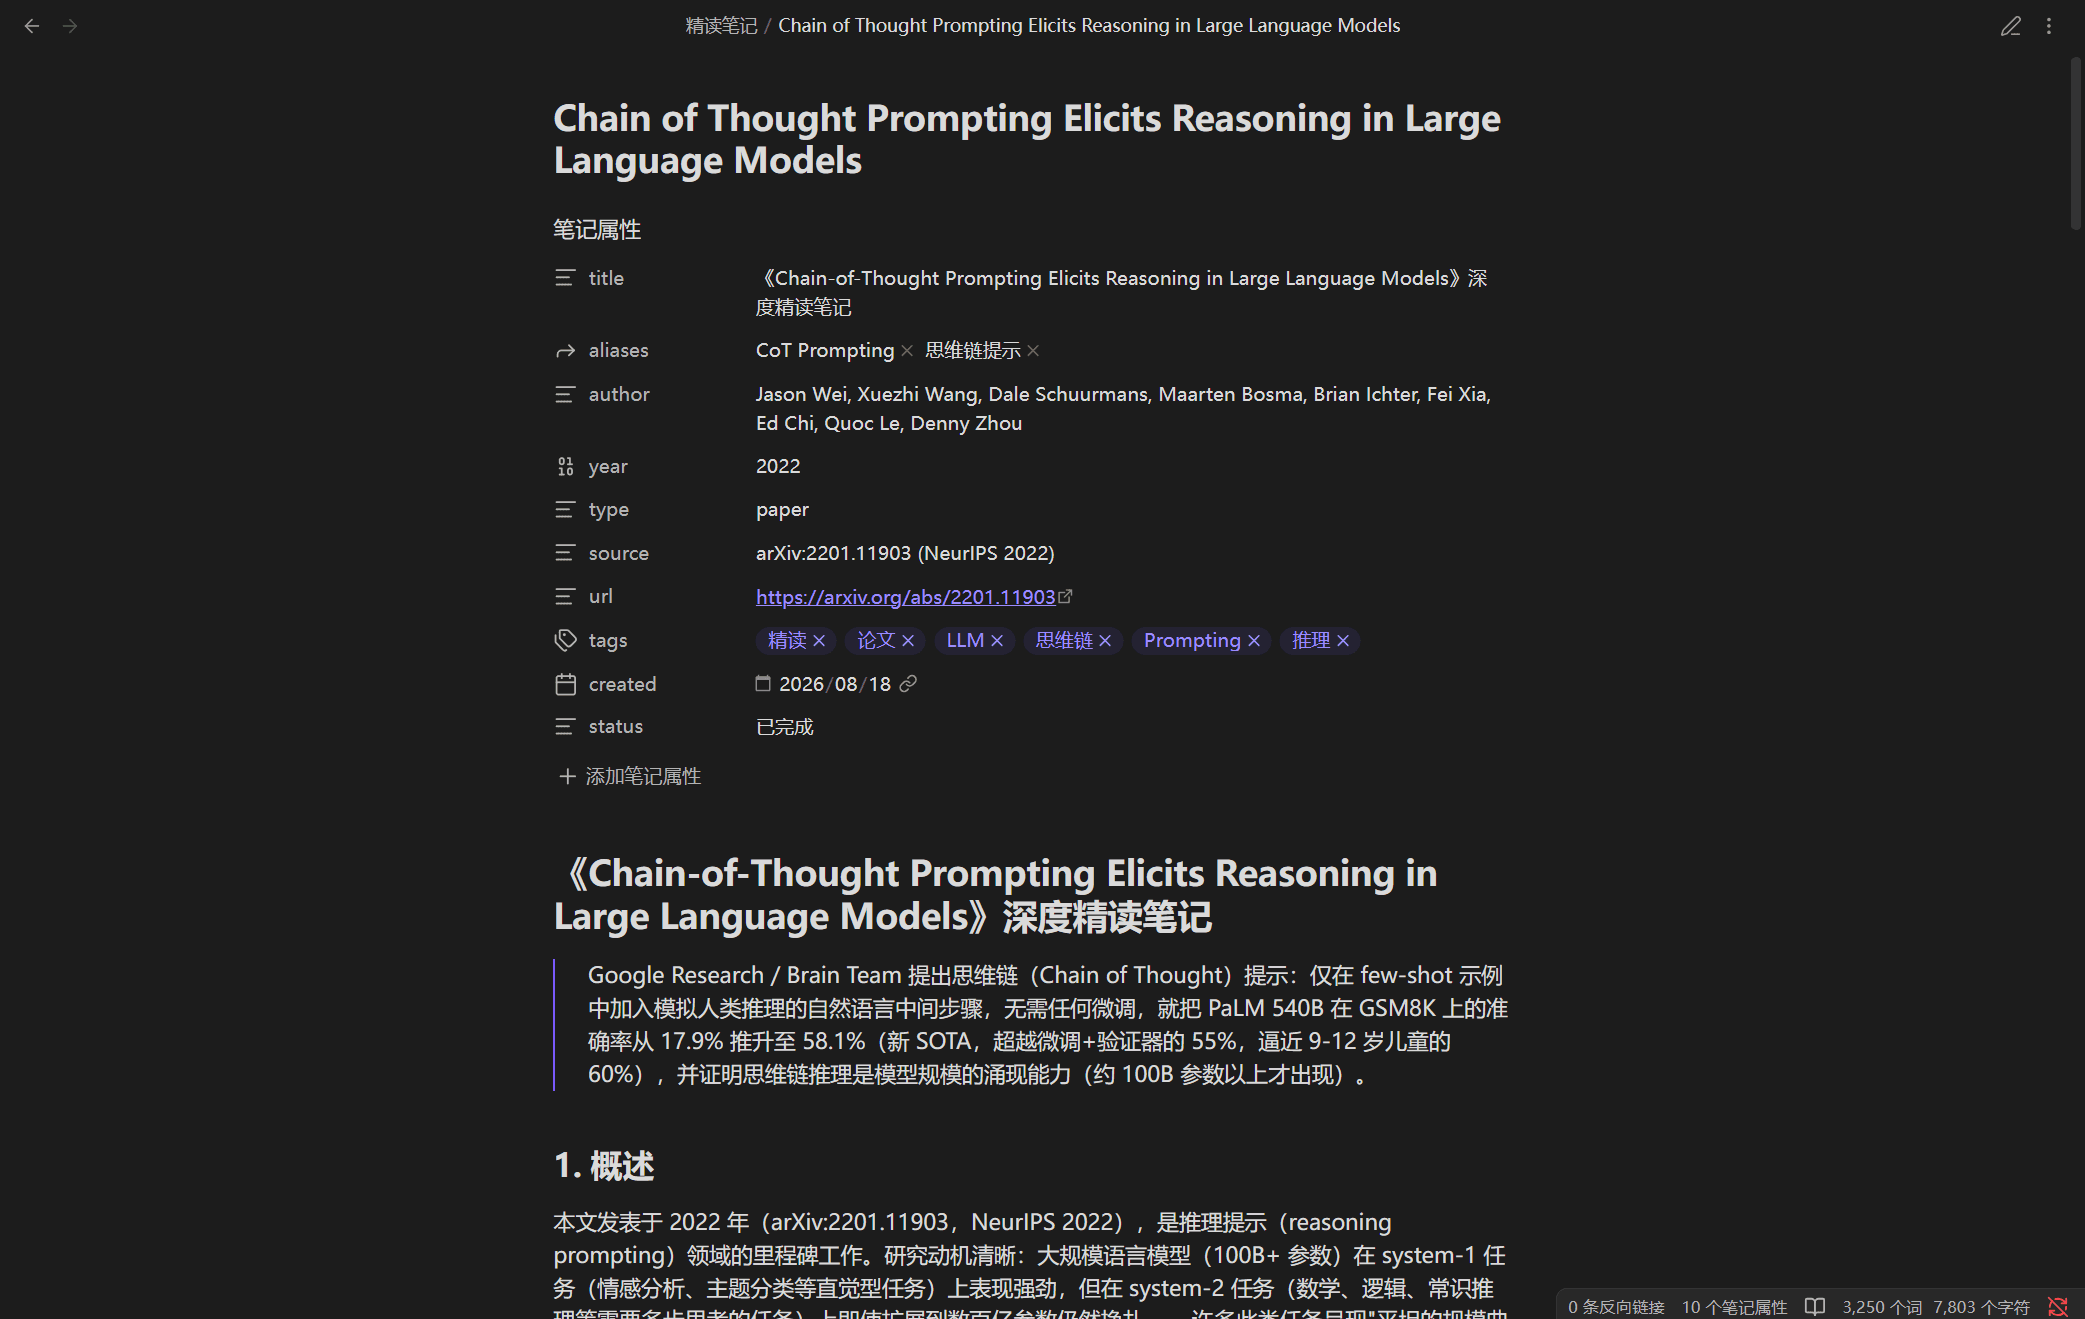
实际效果
(图用 GitHub 绝对地址,npm 页面同样能显示;图片本身不打进 npm 包,只随仓库分发)
| 精读论文 | 视频笔记(元信息) |
|---|---|
| 视频笔记(行动要点) | 会话内摘要 |
|---|---|
能做什么
- 书籍(PDF/EPUB/MOBI)、论文(arXiv/PDF/HTML)、视频(字幕优先,无字幕自动转写,出品完整逐字稿精读)、网页
- 长内容分块后由并行子代理精读,再合并
- 获取/分块与质量校验的输出受 JSON Schema 约束,结构稳定、下游可解析
- 分块计划与子代理数量受
maxChunks强制约束(计划失控会顶穿单次调用时限) - 关键引用必须标注页码/章节/段落,降低编造风险
- 配置错误直接报错终止;某块内容解析失败则跳过并标记缺口
- 输出标准 Markdown + YAML frontmatter:正文是通用 CommonMark(无双链、无 callout),Obsidian(配合 Dataview)、Logseq、Jekyll / Hugo / Astro 的内容目录、任意 Markdown 编辑器都能直接用
结构
输入(链接或文件路径)
  │
  ▼
解析器注册表 ── book / paper / video / web
  │
  ▼
波次1  获取内容 → 写入临时文件 → 生成分块计划
  │
  ▼
波次2  N 个子代理并行精读各块(Map)
  │
  ▼
波次3  合并成稿 + 质量校验(Reduce)
  │
  ▼
Markdown 笔记
三个波次,默认约 N+3 次子代理调用(获取、N 块精读、成稿、质量校验)。auto 遇到 PDF、未知网页或文本等模糊输入时,额外进行一次轻量类型识别;显式指定 type 可跳过识别。
auto 会将明确的视频链接、arXiv 论文链接和电子书扩展名直接分发到对应解析器;同站的专栏、频道与帮助页仍先分类,PDF 会根据内容区分书籍与论文。无法识别时返回 stage: "detect",请显式指定类型。options.tempDir 作为临时根目录,每次调用在其中创建独立的 run-* 子目录,获取、音频和转写文件不与其他任务共用。
分块计划会排序、裁掉重复区间并补齐缺口,超过 maxChunks 时合并相邻块以保留全文。返回的 coverageComplete 表示是否依据有效的 totalLines 覆盖全部行号;缺少总行数时保留已知范围,同时将 qualityPassed 置为 false 并说明覆盖无法确认。
质量检查分两部分:程序按提供的标量/列表 frontmatter 模板检查字段、必要章节和篇幅(汉字按字、其他文字按词,排除 frontmatter、代码块、HTML 注释及链接地址);独立核验代理读取本次原文文件,逐块检查覆盖,并为第 4 节的逐字引用返回原句和行号。单独的 pass: true 无法通过检查。qualityChecks 返回检查项,qualityEvidence 返回原文路径、分块摘录和引用证据;原文真实性判断仍由读取原文的代理完成,无法核实就报告未通过。修订为空、调用失败或结构退化时保留上一份有效成稿。
直接调用 workflow 的 options 必须类型正确:minWords 为 1–100000 的整数,maxChunks 为正整数(大于 12 仍夹到 12),maxRetries 为 0–3 的整数;非法值和未知键在启动时 FATAL。插件 profile 的 config 则逐项告警并回退默认值,避免阻止宿主启动。
parsers/         各输入类型的解析器,按类型分发
  book.js        书籍:PDF/EPUB/MOBI 文本提取、章节分块
  paper.js       论文:arXiv/PDF/HTML 结构识别
  video.js       视频:完整逐字稿(字幕优先,无字幕自动转写,走 scripts/transcribe.js)
  web.js         网页:正文提取
  index.js       注册表:解析器发现与回退
schemas/         输出约束的 JSON Schema(波次1 由 workflow.js 注入脚本,单一真相)
scripts/         lint(含换行/空白卫生检查)、安全检查、跨平台转写引导(transcribe.js)
lib/             独立可用的小工具
  cache.js         输入指纹与幂等记录(供自己驱动流程的调用方使用;workflow 沙箱没有文件系统,用不到它)
  workflow-script.txt  workflow 脚本正文(普通文本,可直接读改,不需要任何转义)
tests/           测试与验证脚本(**不随 npm 包发布**,仓库里才有)
workflow.js      workflow 的 meta 与组装逻辑(解析器内联、schema 注入)
脚本正文单独放
lib/workflow-script.txt:这个文件曾经因为「转义套转义」被改坏过两次,现在它是普通文本,读改都不需要编码步骤。
…
