Flyvhidbwo/dsh-vision-proxy
dsh-vision-proxy
dsh-vision-proxy is a community DeepSeek Harness plugin. Read the repository README before installing.
Install
npx @deepseek-ai/dsh plugin --profile web add dsh-vision-proxyRestart `dsh web` after install. Bundle APIs can change during the developer preview.
README badge
[](https://dshhub.dev/plugins/dsh-vision-proxy)Paste this into your README. The star count updates with every catalog sync.
From the README
Excerpt from Flyvhidbwo/dsh-vision-proxy, cleaned of badges and images.
dsh-vision-proxy
保持 DeepSeek 作为对话大脑,图片照样直接发。 为 DeepSeek Harness 打造:GUI 附加图片自动转译,纯文本 DeepSeek 也能识图。
⚠️ 兼容性与定位(2026-08):本插件已适配 dsh 0.1.1-rc.2(adapter prepareCall 接口)。dsh 0.1.1 起原生支持多模态(DeepSeek-V4-Flash-Vision-Exp 等官方视觉模型)——如果你用官方视觉模型,直接发图即可,不需要本插件。DeepSeek-V4-Pro / 普通 Flash 仍是纯文本模型,识图靠本插件转译桥接(官方仅 Flash-Vision-Exp 原生多模态)。插件适用于:Pro/文本模型识图、本地 Ollama(图片不出本机、免费)、自定义 OpenAI 兼容 VLM 场景。
为什么需要它
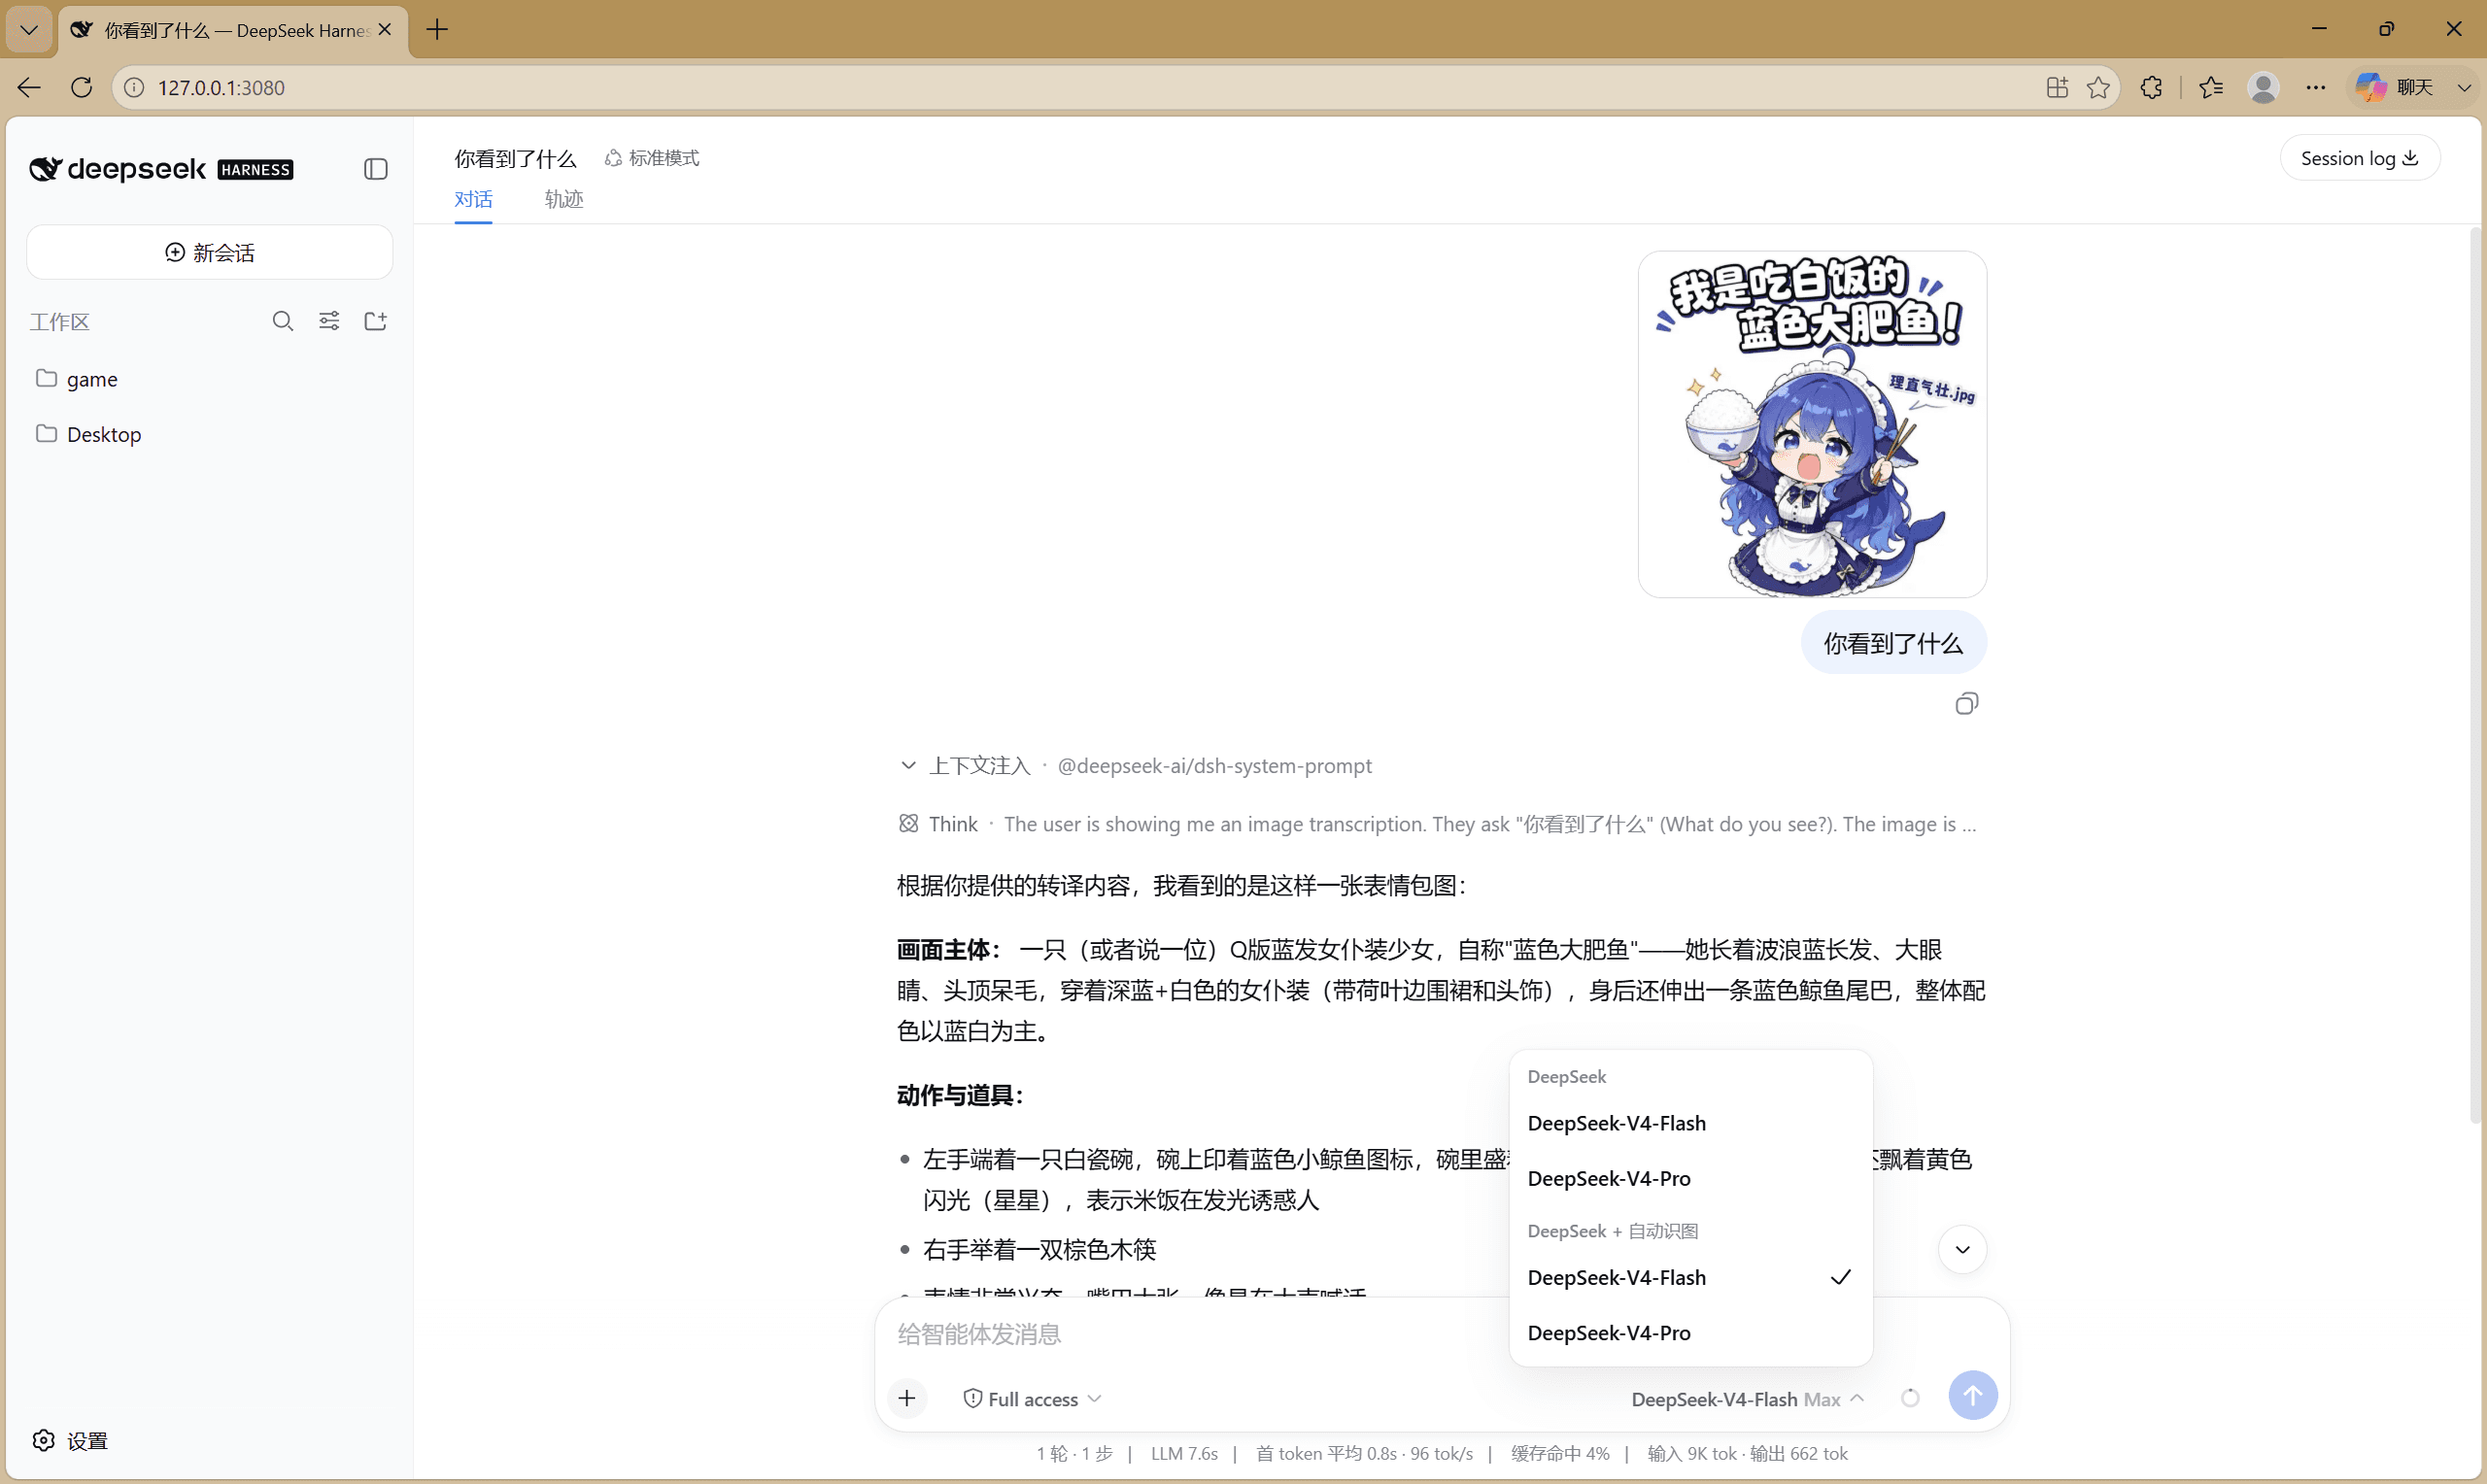
DeepSeek Harness 原生按模型声明的 inputModalities 决定是否放行图片附件。DeepSeek 的 chat-completions 线路是纯文本的,所以选中 DeepSeek 时附加图片会被原生拒绝。已有的视觉插件提供 view_image 等工具(适用于文件路径),但 GUI 图片附件对纯文本模型依然失败。
本插件补上这个缺口:注册一条新提供商路由(deepseek-vision),包装真正的 DeepSeek 适配器——对外声明支持图片输入(附件预检放行),并在请求流里把每张附加图片转译成文字后再委托给 DeepSeek。对话仍然由 DeepSeek 作答,识图只是附加能力。
用户附加图片 ──▶ deepseek-vision 路由 ──▶ 经 VLM 转译(OCR+版式+细节)
                   │                        │
                   ▼                        ▼
            DeepSeek 作答 ◀── 纯文本对话(图片已替换为 [图片转译] 文字)
特性
- 绝不卡死。匿名端点强制 20 秒超时上限(免费档挂起也拖不住整轮对话);匿名端点遇到 HTTP 429 立即失败(不做无意义的 Retry-After 等待);刚失败(429/超时)的端点进入 60 秒冷却并被跳过。
- 多模型、多厂商。任何 OpenAI 兼容 VLM 端点都行——百炼/Qwen、QwenCloud 国际站、智谱、OpenRouter、本地 Ollama、或你自己的端点。每条
fallbackModels都可以带各自独立的baseURL/model,一个安装即可串联多家。 - 零配置本地路径。
autoLocalOllama(默认开)启动时探测http://localhost:11434,检测到 Ollama 就自动加入降级链——图片不出本机,免 key 免注册。 - 快速且明确的失败。没有 key 也没有本地 Ollama 时,转译在几秒内失败并给出可操作指引(配置
VISION_API_KEY/DASHSCOPE_API_KEY或安装 Ollama)——绝不静默卡住。 - 有 key 自动提速。导出
VISION_API_KEY/DASHSCOPE_API_KEY后自动走你配置的付费端点(默认百炼qwen3.7-flash——快、便宜、不限速;百炼/QwenCloud/智谱/OpenRouter 或任意 OpenAI 兼容端点均可);没有 key 的条目会被跳过而不是失败。 - 安装时一问式确认。
postinstall询问你是否有 VLM API key。非交互环境自动跳过,安装永不卡死。启动时打印 PRIVACY NOTICE 标明当前使用的端点。 - 降级链 + 错误分类。
rate_limit/quota/auth/region/model_not_found/context_too_large/http分类给出可操作提示。 - 内容哈希缓存。转译结果按图片字节的 SHA-256 缓存(进程内,上限 200)——同一张图每个进程最多转译一次,重新附加或换对话也命中。
- 自动降采样(可选)。装有
sharp时,超过maxImagePixels的图片转译前自动缩小——大截图更快;没有 sharp 则优雅降级原图直发。 - 兼容
read_image。原生read_image工具在该路由下同样可用(它的能力门禁读取同一份模型信息)。
支持的模型与厂商
一套配置(baseURL + model,可选 apiKey)覆盖所有后端:
| 场景 | baseURL | model | 说明 |
|---|---|---|---|
| 百炼(国内)——默认主模型 | https://dashscope.aliyuncs.com/compatible-mode/v1 | qwen3.7-flash / qwen3-vl-flash | 便宜、快、不限速。密钥:千问平台 sk-ws-… 或百炼 sk-… |
| 本地 Ollama(自动探测) | http://localhost:11434/v1 | 第一个视觉模型 | 装了就零配置可用;图片不出本机 |
| QwenCloud(国际) | https://dashscope-intl.aliyuncs.com/compatible-mode/v1 | qwen3-vl-plus 等 | 国际版 |
| 智谱(免费档) | https://open.bigmodel.cn/api/paas/v4 | glm-4.6v-flash | 免费档仍需注册智谱(免费)key |
| 任意 OpenAI 兼容端点 | 你的端点 | 你的模型 | OpenRouter、火山 Ark、vLLM、各类网关……插件只讲 /chat/completions |
⚠️ 不再内置任何第三方匿名免费端点作为默认兜底。实测中匿名免费端点(如 OVHcloud AI Endpoints)限速极严且会无响应挂起——作为默认只会复现"卡死"体验。如果你仍想用某个匿名端点,请通过
fallbackModels自行添加并设anonymous: true(20 秒超时上限依然生效)。
价格参考(人民币,百炼国内站 2026-08 参考价)
| 模型 | 输入 | 输出 | 一张 1080p 截图(≈2000 token) |
|---|---|---|---|
| qwen3-vl-flash | ¥0.15/百万 token | ¥1.5/百万 token | ≈ ¥0.0005(约 0.05 分钱) |
| qwen3.7-flash | ¥0.2/百万 token | ¥0.8/百万 token | ≈ ¥0.001(约 0.1 分钱) |
| deepseek-v4-flash-vision-exp(官方,默认) | ¥3/百万(高峰)· ¥1.5(空闲) | ¥9/百万(高峰)· ¥4.5(空闲) | ≈ ¥0.01(高峰)/ ¥0.005(空闲) |
| 本地 Ollama | 免费 | 免费 | ¥0(图片不出本机) |
温馨提示:识图默认走官方 deepseek-v4-flash-vision-exp(高峰 9:00-12:00 / 14:0
…