webkubor/dsh-mirror
dsh-user-mirror
dsh-user-mirror is a community DeepSeek Harness plugin. Read the repository README before installing.
Install
npx @deepseek-ai/dsh plugin --profile web add @dsh-plugins/dsh-user-mirrorRestart `dsh web` after install. Bundle APIs can change during the developer preview.
README badge
[](https://dshhub.dev/plugins/dsh-mirror)Paste this into your README. The star count updates with every catalog sync.
From the README
Excerpt from webkubor/dsh-mirror, cleaned of badges and images.
<strong>让 AI 记住你怎么想,而不是你说过什么。</strong><br> DSH 插件 —— 模型主动记下你的原则、红线与工作方式,跨会话复用。<br> 会遗忘、有容量上限、每条都说得出为什么记。
· <a href="CHANGELOG.md">更新日志</a> · <a href="DEV_NOTES.md">开发笔记</a>
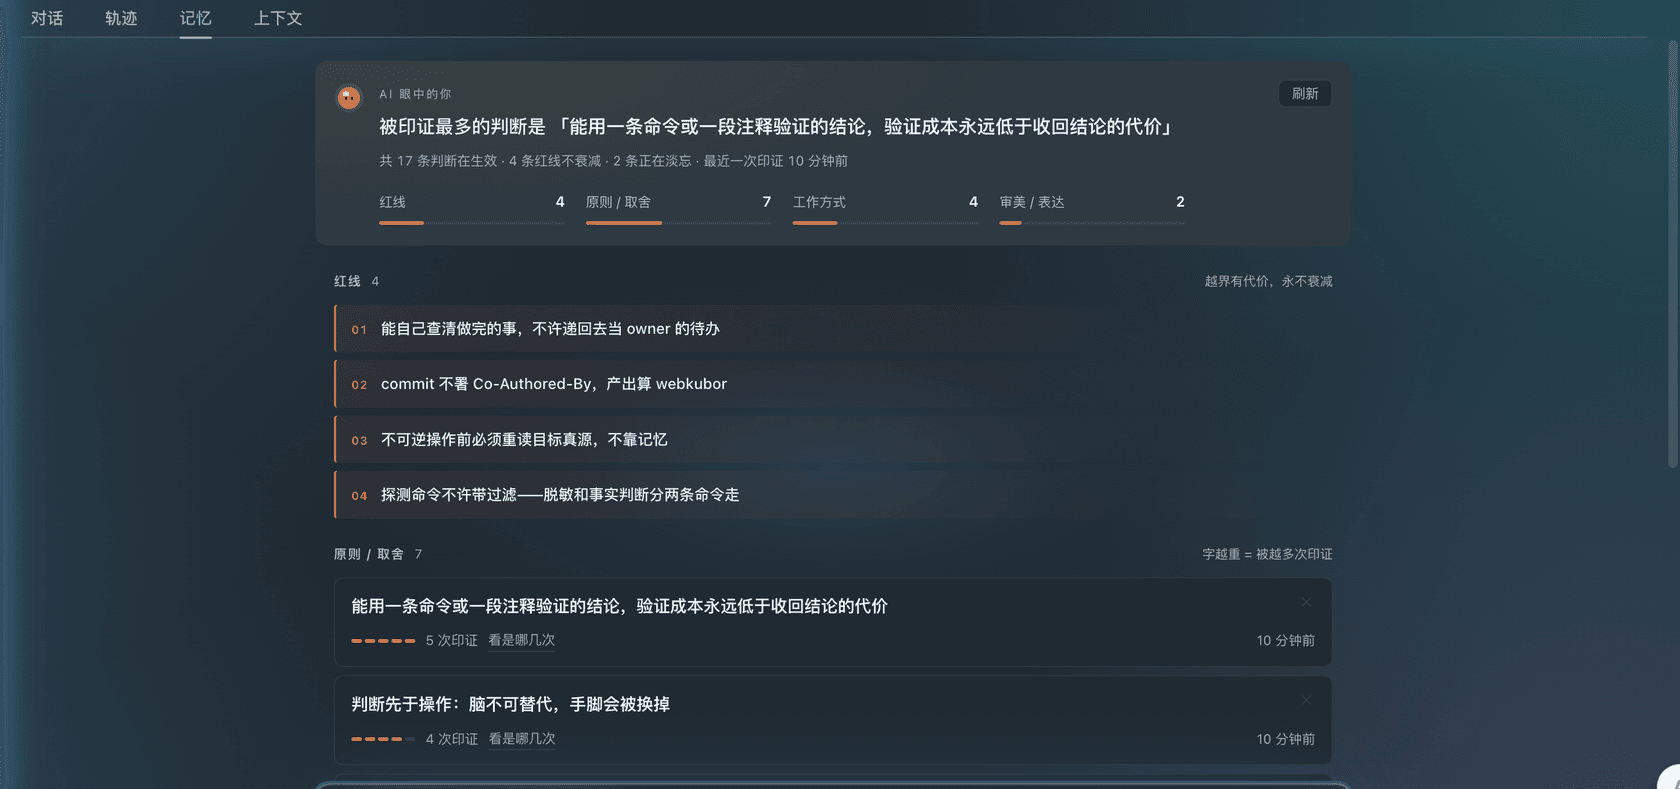
<br /> <sub><b>记忆 tab</b> —— 不是一份记录列表,是一张画像:一句话速写、四类判断分区、<br/> 红线单独成块,每条判断的字重就是它被印证的次数。</sub>装它和不装它的区别
| 不装 | dsh-user-mirror | |
|---|---|---|
| 换一个会话 | 你的原则要重讲一遍 | 自动注入,模型已经知道 |
| 模型到底记了什么 | 不透明,只能猜 | 记忆 tab 里一条条列出来 |
| 它凭什么记这条 | 无从追溯 | 每条都带理由,点开就看到 |
| 记多了会不会塞爆上下文 | 会 | 按 token 预算注入,不按条数 |
| 记错了怎么办 | 只能重开会话 | 点一下撤掉 |
| 过时的偏好 | 一直留着误导模型 | 会遗忘 —— 30 天没被印证就进淡忘区 |
这是什么
一个 DSH 插件:让模型主动记下「你怎么想」,跨 session 复用,再注入回系统提示。
- 🧠 学 —— 模型意识到你表达了可复用的判断依据时,调用
mirror_remember记下来,并写下为什么记 - 💾 记 —— 用
ctx.storageDomain本地持久化,有容量上限、会遗忘、新认知覆盖旧的 - 🎯 用 —— 自动注入 system prompt,按 token 预算 注入,不是条数
只记判断依据,不记事实
这是这个插件唯一重要的取舍。事实(路径、账号、服务器、仓库地址)另有真源, 这里再记一份就是第二真源,两边迟早打架。所以它只收 cs 那类真源里没有的东西 —— 你的原则、取舍、红线、工作方式。
这同时也是「人脑不能无限递增」的解法:判断依据天然有限(几十条量级),事实无限。 只收前者,容量就不是靠淘汰硬撑出来的。
| 分类 | 记什么 |
|---|---|
principle | 原则/取舍 —— 什么情况下怎么选 |
redline | 红线 —— 绝对不要做什么 |
workflow | 工作方式 —— 流程与协作习惯 |
taste | 审美/表达 —— 措辞、风格、呈现 |
为什么不从 think 链里猜
v0.4 之前是用正则扫模型的 reasoning 流,找「用户偏好…」这类复述。实测在真实数据上 命中 0 次 —— 它赌模型会用某种特定中文句式复述你,这个假设太脆弱;而且就算命中, 「用户想让我改这个按钮」这种一次性意图也会被当成长期偏好记下来。
「这算长期原则还是一次性请求」是判断,正则是手脚,手脚做不了这个判断。所以改成 模型自己判断、主动调用工具 —— 顺带解决了可解释性:每次记录都发生在对话里,看得见, 每条都带理由,而不是背后悄悄写。
记忆 tab 长什么样
安装后,「对话 / 轨迹」后面会多一个**「记忆」tab**。它不是一份记录清单,是一张画像:
- 一句话速写 —— 顶部直接给出「被印证最多的那条判断」,那就是模型眼里最认定你的一条
- 四类分区 —— 红线单独成块(越界有代价,且不参与遗忘),原则是主体,工作方式与审美压成两栏
- 强度就是字重 —— 被印证越多的判断字越重越实,弱的退成灰字;不显示「强度 3.7」这种对人没意义的数字
- 证据折在判断里 —— 正面只放抽象后的判断,点「看是哪几次」才展开它从哪些具体事件来的
- 正在淡忘 —— 30 天没被印证的判断进折叠区,让「会遗忘」这件事看得见
- 每条可以点
✕撤掉。两段式:第一下只变成「确认撤掉?」,再点才真删 —— 删除端点只认 DELETE/POST,GET一律 405,免得被浏览器预取或前进后退重放误删 - 一颗 ai-orb 状态球会表态:读取中 / 刷新中 / 刚记下(带角标)/ 失败
记忆模型:有结构、会遗忘
记忆不是无限递增的——人就是会遗忘,新认知覆盖旧认知:
| 机制 | 规则 |
|---|---|
| 强度 | 强度 = 命中次数 × 时间衰减(遗忘曲线) |
| 遗忘 | 半衰期默认 30 天:多久没被再次确认,强度减半 |
| 覆盖 | 同主题的新说法覆盖旧的(不新增近义条目) |
| 封顶 | 默认 20 条上限,满了淘汰强度最低的 |
| 预算 | 注入按 token 预算(默认 500),不是「塞全部」 |
同主题判定走两条通道:英文实体(r2 / picx / main 这类词在技术语境里几乎等于
主题标签,共同命中两个即判同主题)+ 中文二元组重叠。已知边界:同义但完全换词的
纯中文(「回复一律用中文」vs「一律中文回复,术语保留英文」)会漏检,多存一条。
真要修得上 embedding,不值得为此加重量级依赖 —— 而且模型记录时看得见已有记忆,
防重主要靠它,findSimilar 只是兜底。
已知限制:改写幅度大的中文同义句会被记成两条
同主题判定走两条通道 —— 英文实体(r2 / picx 这类技术名词,共享两个即判同主题)
和中文 bigram 重叠(阈值 0.3)。纯中文表述只差一两个字时能正确合并
(实测相似度 0.67–0.77),但换一种说法就会漏判:
| A | B | bigram 相似度 | 结果 |
|---|---|---|---|
| 提交之前一定要跑一遍测试 | 提交之前一定要先跑一遍测试 | 0.77 | ✅ 合并 |
| 删东西之前必须先问我 | 要删掉东西之前先来问一下我 | 0.18 | ❌ 记成两条 |
原因是 bigram 只看字面重叠,不理解同义。条目有上限,重复条目会挤掉真正有用的记忆。
现在的对策:mirror_remember 时尽量沿用已有表述;发现重复用 mirror_forget 删掉一条。
根治要靠同义归并(词向量或让模型自己判重),尚未做。这条限制被测试锁住
(test/memory-core.test.mjs 的「已知缺陷」用例),将来改进时那条会失败,提醒同步更新。
安装
dsh plugin --profile web add @dsh-plugins/dsh-user-mirror
⚠️ 只能装在提供 storageDomain 和 webServer 的 profile 上(也就是 web)。
headless profile 两个服务都没有,插件会停在 pending (waiting for services: storageDomain, webServer) 并让整个 boot 失败 —— 前者是记忆持久化的根基,
后者是「记忆」tab 取数据的通道。
关于 ai-orb 的 vendoring
…